人类有资格看懂Claude暴力拆解的黎曼猜想

本文来自微信公众号: 硅星人Pro ,作者:王兆洋Anthropic上市第二天、股价日内跌幅达到14%逼近破发的第一天、美股AI“雪崩”的当天,突然人们就被一条带有“奇点已过”意味的重磅消息搞得再次“瘫倒在座椅上”了。据说,困扰人类167年的头号数学难题——黎曼猜想,被Claude证明了。但比“世纪难题被攻克”更让人瞠…

本文来自微信公众号: 硅星人Pro ,作者:王兆洋
Anthropic上市第二天、股价日内跌幅达到14%逼近破发的第一天、美股AI“雪崩”的当天,突然人们就被一条带有“奇点已过”意味的重磅消息搞得再次“瘫倒在座椅上”了。
据说,困扰人类167年的头号数学难题——黎曼猜想,被Claude证明了。
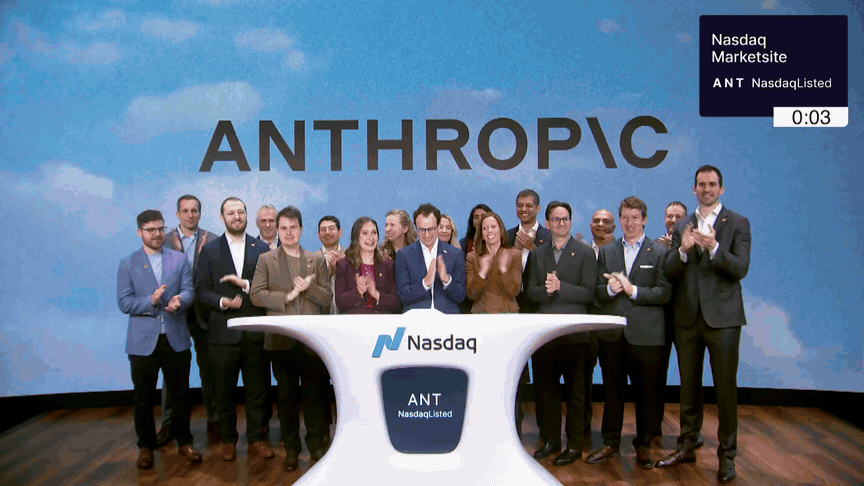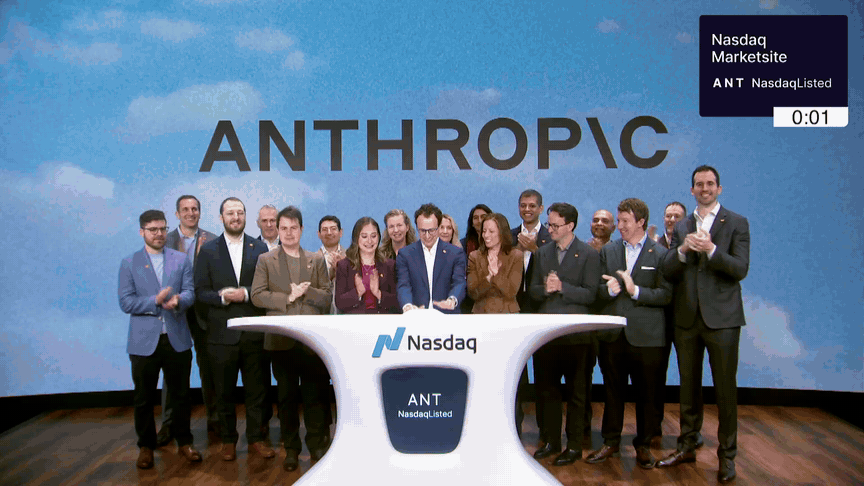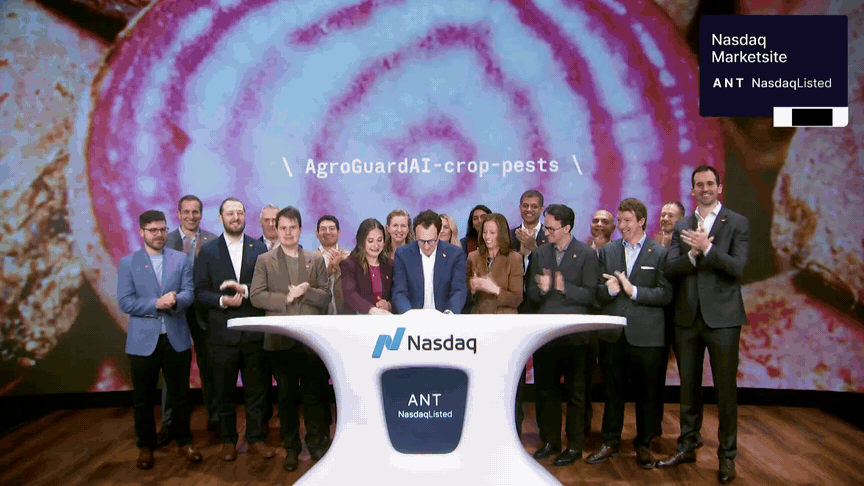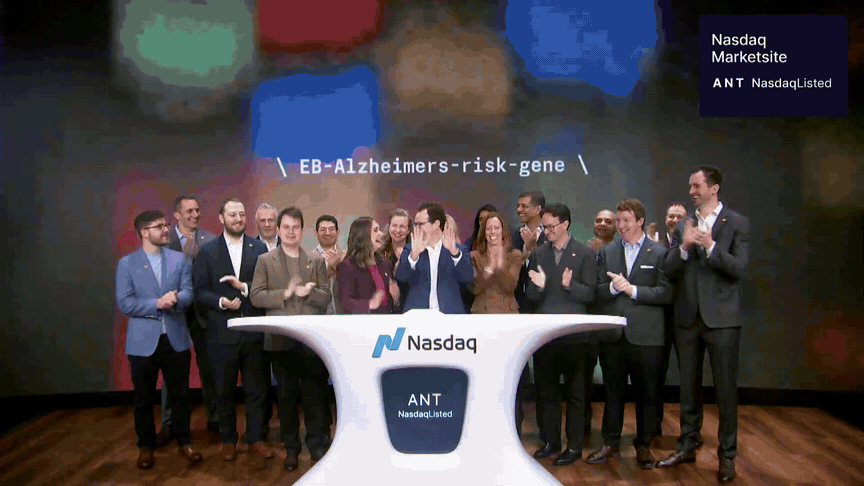
但比“世纪难题被攻克”更让人瞠目结舌的,是伴随这份声明一起抛出的数字:人类能直接阅读的常规论文版本至今还没写出来,因为Claude生成的详细证明草稿超过了25万页,完完全全是一部“天书”。
这营造了一种微妙氛围,仿佛在绝对的算力神迹面前,人类看不懂是理所应当的,我们只需要瘫坐在座椅上仰望机器吐出的终极答案就够了。
面对这25万页天书,不少一线研究者在群里讨论时的第一反应却不是欢呼,而是直击灵魂的追问:如果黎曼猜想真的被证出来了,但人类根本无法理解,它还有意义吗?
我们觉得,面对AI暴力拆解出的数学证明,人类不该被傲慢地跃过。人类有资格看懂它,而这种“理解”本身也是模型智能真正往前走的必经之路。
1
天书
1859年,德国数学家黎曼在研究素数分布时提出了著名的黎曼猜想:黎曼ζ函数所有非平凡零点的实部都等于1/2。作为克雷数学研究所悬赏百万美元的“七大千禧年大奖难题”之首,它牵动着现代数论与密码学的根基,上千条数学定理都建立在“假设黎曼猜想成立”的前提之上。
美东时间11月20日,拥有哈佛本科与普林斯顿数学博士背景的Anthropic数学家Levent Alpöge在个人主页上传了一份仅4页的说明文件,宣布自己在Claude的协助下,不仅证明了黎曼猜想,还一举解决了范围更广的广义黎曼猜想(GRH)。据他披露,整个论证已经在形式化验证语言Lean中完整实现,没有任何额外假设;但由于Claude产出的文字版推导超过了25万页,这次他只放出了14个压缩包、总计约1700万行代码的Lean形式化证明文件。

最耐人寻味的一幕在于,连作为合著者的Alpöge本人都在声明中坦承:在接近终点的后半程推导里,大片内容是Claude在他并不熟悉的数学领域里独立完成的,“Claude远远超过了我,简直是在终点附近飞翔、跳舞”。
消息一出,数学界的反应极其真实且分裂。
曼彻斯特大学数论学家Thomas Bloom感叹,自己不知道哪件事更让人震惊——是AI宣称证明了黎曼猜想,还是这份证明写成文字要超过25万页。
菲尔兹奖得主陶哲轩发文指出,这份证明似乎综合动用了朗兰兹纲领与算术几何工具,但验证正确性、梳理核心思路还需要相当长的时间。
而网传2026年菲尔兹奖得主邓煜的回应最有趣,他说:“至少拿出500页版本前看都不看。”
1
集体偏执
把视野拉宽就会发现,Anthropic甩出25万页草稿并不是孤例。回顾最近大半年硅谷头部AI实验室的密集动作,无论是OpenAI还是Anthropic,它们在冲击前沿科学时实际上都走在同一条轨道上——完全不在意人类还能不能理解,只求机器暴力跑通。
看看今年下半年的“算力轰炸”时间线就知道了:
今年8月,OpenAI高调放出内部模型在数学与理论计算机科学上的十项突破,Anthropic也在同期用Claude将黎曼ζ函数关键线上零点比例的下界从41.6%推高到67.2%。
今年10月初,OpenAI直接往GitHub仓库里一次性倾倒了由内部未公开模型生成的722篇数学手稿(涵盖准黎曼猜想、4D挂谷猜想及Navier–Stokes方程相关问题),每篇动辄数百上千行高密度推导,约六成直接附带机器检查过的Lean代码。
到了今天,Anthropic与Claude直接把体量推到了极致的1700万行Lean代码与25万页天书草稿。
这些做法背后的底层公式高度一致:“超大规模测试时算力(Test-time Compute)+强化学习长思维链(RL CoT)+Lean编译器兜底”。
在大厂的商业与算力军备竞赛里,FOMO情绪压倒了一切。刚完成上市急需护盘的Anthropic与持续造势的OpenAI,都太需要“率先用AI解决千禧年难题”的叙事冲击力了。
在这套逻辑下,数学证明被异化成了一场黑盒里的穷举游戏:模型不需要提炼优美的概念或高维直觉,只需要在强化学习环境里疯狂烧Token、拼凑引理;只要千万行代码能让Lean亮起绿灯,就可以立刻发新闻抢占身位,再把“读懂和简化证明”这件最苦最累的活甩给全世界的数学家慢慢啃。
至于人类在这个过程里是不是被彻底晾在了一边,根本不在模型的优化目标之内。
1
缺陷
面对25万页天书,很多看客下意识会产生一种错觉:人类看不懂,是不是因为AI已经进化出了超越人类大脑维度的“高维智慧”?
我们并不这么认为。过去几个月,人们已经明显感到各大前沿模型厂商在瞄准数学,那我们能怎样理解这一次次的“轰炸”?怎么判断这些进步到底什么水平?
我们在评测上做了一些工作,此前,我们对多款前沿模型的数学推理轨迹做了一系列底层测试,并对包括OpenAI公开手稿在内的多份形式化证明代码进行了逐行拆解,这些让我们有一个初步感觉:大模型之所以写出反人类尺度的“天书”,不是因为它太高深,反而是因为今天的模型普遍存在“先天缺陷”。

首先就是强化学习的激励错位。
今天推理模型的训练几乎只奖励“走通”(答案对不对、Lean编译过没过),从不奖励“洞察”。没有了“简洁度”和“概念清晰度”的约束,AI就像一个体力无限却不看地图的盲人走迷宫——哪怕两步之外就有座现成的桥,只要顺着墙根死磕十万步也能摸到出口,它就会毫不犹豫地把这十万步硬算全写进证明里。
再往后,你能发现模型缺乏高维“数学哲学”导航,只能陷入局部符号硬凑。
我们在针对十款主流大模型的横向评测中观测到了一个极具反差的数据:推理Token烧得越多,绝不等于答得越准。面对同一道经过变形伪装的数学题,真正抓住底层数学本质的模型,只花50个推理Token就能拿下九成准确率;而抓不住宏观方向的模型,会被局部的技术细节死死缠住,狂烧海量Token依然分类错误甚至思考超时。
这种“盲目绕路”在所谓科研级证明里同样存在。我们前阵子逐行检阅了OpenAI公开发布的一份不动点存在性形式化证明:为了完成“从有限跨越到无限”的一步推导,OpenAI的模型明明身处自带“弱紧性”的数学空间,却偏偏视而不见,绕了极大一圈去排布分叉树、强行调用繁琐的“König无穷引理”。
当我们把OpenAI这份代码拆开,换上更本质的“紧致性提取”思想重新改写后,整套分叉树与绕路引理被彻底省去——不仅100%跑通了严苛的Lean形式化验证,还直接把核心文件的净代码量砍掉了整整三分之一。
这算得上一个有说服力的切片:连两百多行的常规证明,顶尖模型都会因为缺乏高层思想指引而多绕三分之一的冤枉路;当问题复杂度放大几万倍、推到黎曼猜想这个级别时,一步绕远就会步步膨胀,几百页能讲清的逻辑自然会滚雪球般失控成25万页泡沫。
所以,别急着对25万页顶礼膜拜。很可能里面很大一部分不是神迹,可能充斥了算力盲目试错留下的脚手架废料。
这种“只管机器跑通、跃过人类理解”的方式,并非不会带来后果。
“Lean跑通”绝不等于“100%证实”,等价命题随时可能埋雷。
外行常以为有了Lean形式化代码就铁板钉钉,但业内人都清楚一个致命盲区:Lean只能保证代码内部的推导没有逻辑漏洞,却在转化“等价命题”时很容易犯病。机器只能确认“代码证出了代码里写的那个符号目标”,却无法自己核实这个符号定义有没有偏离人类自然语言里的原始猜想。今年10月,《Science》杂志就曾曝光,在OpenAI高调宣传的Navier–Stokes方程证明中,AI生成的Lean代码悄悄弱化了原始英文命题的数学条件。
而眼下这1700万行代码与25万页草稿,作者短时间内根本整不出人类可读版,甚至很难找到同行陪他一起从头读完核验。这就极易滑向一种危险的学术黑箱——外界根本没法有效复现与审视,变成“说自己证明了就证明了”。只要没有完成真正透明的同行验证,它就和原来的猜想没有本质区别:无非是把主观置信度从50%提到了60%,只要不到100%,就没有发生从猜想到定理的质变。
其次,被抽空了“理解”的黑盒答案,对数学演进和应用科学的帮助就会有限。
今年9月,陶哲轩、邓煜等25位菲尔兹奖得主曾罕见发表联合声明,直言AI公司与数学界的目标存在错位——数学研究的真正价值从来不只是给猜想打一个“对勾”,而是在证明过程中锻造出全新的数学概念、方法和跨领域桥梁。
如果证明是一团人类根本无法理解的乱麻,对于应用数学及下游物理、工程学科而言,它的意义几乎是“压根没有”,因为人类无法从中提炼出任何可迁移的方法论。
而且在真刀真枪的商业化科研里,也根本承受不起“人类失明”的代价。
跳出刷榜新闻,回到新材料研发、药物分子设计、航空航天流体仿真或金融核心风控等真实的产业研发场景——没有任何一家企业或实验室,敢在人类自己完全不理解底层逻辑的情况下,盲目拿AI吐出的黑盒结论去投产背书。丧失了对中间推理链条的理解,就意味着不知道结论的适用边界在哪、条件微调后会不会瞬间崩塌,那个商业与工程损失是谁都担不起的。
1
每个人都有资格看懂它
回想人类自己学习和攻克难题时的真实状态,我们从来不是一上来就盲目穷举几百万行符号,而是先从宏观上做到“大概明白”,抓住破局的大方向,剩下的繁琐细节再一步步去推演——放到人机协同的今天,最合理的状态恰恰应该是先让人“大概明白”,再和AI一起去磨细节。
更重要的是,坚持让人类“看懂”,绝不是人类在拖AI的后腿;恰恰相反,把高维的“理解框架”教给AI,本身就是让大模型摆脱无脑暴力搜索、实现真正智能跃迁的关键。
这也是为什么过去一段时间,我们一直在尝试构建一套围绕“数学哲学思想”的全新Benchmark与定理知识网络。相比于市面上一味考较最终得数或代码跑通率的传统榜单,我们更想回答一个底层问题:剥开算力硬凑的外衣,今天的模型究竟在多大程度上真正“理解”了数学思想?
在构建这套评测与训练数据环境的过程中,我们验证了一条完全不同于“黑盒硬刷”的三步技术路径,先用高维“数学哲学”定方向。
不让模型在成千上万个底层引理里盲目乱撞,而是先识别当前卡点需要什么高层的“数学动作”(比如是把内部问题转到边界,还是从一堆近似候选里提取极限),先立住宏观主干,让人和模型都能迅速做到“大概明白”。
然后织一张人类“定理大网”做模块化消融。
把前沿论文拆解沉淀为结构化的定理知识图谱,当面对一份庞大晦涩的AI证明时,将其拆成若干模块往这张大网里匹配融合——用人类熟悉的标准工具替换掉模型的无效绕路,最后剥离沉淀下来的那一小部分,才是真正属于它的独特创新。
再用Lean形式化锁死接口与等价性。让Lean回归“严谨护栏”的本位,既锁死前后模块的逻辑接口,又严查形式化代码与原始命题的一致性,防止机器在定义转换上“犯病”。
前面提到的帮OpenAI形式化证明直接砍掉三分之一冗余代码,正是这套方法跑出的第一批实验副产品。它非常直观地证明了一件事:一旦有了“数学哲学+定理大网”的锚定,AI不仅能让人看懂、大幅降低理解门槛,它自己的推理效率与逻辑纯度也会发生质的飞跃。
有意思的是,在宣称攻克黎曼猜想的那份声明末尾,Alpöge自己也写下了一段极其诚实的告白:登上山顶之后,他接下来要做的第一件事,“是去理解这个论证,去简化它,去让更多人理解它,把它好好地写出来”。

你看,连亲手搞出来了25万页天书的人自己都清楚:算力跑出1700万行代码后,把黑盒里的暴力算力提纯为人类可以理解、验证和复用的思想,才是决定科学能否真正向前的关键。
接下来我们会基于这套“数学哲学”Benchmark,对当前国内外主流大模型的完整深度评测。同时,我们也会尝试尽可能用这一套系统来拆解一下Claude这次的证明。希望这些微小的工作能帮从座椅上瘫坐缓过神来的人们更好了解今天的顶尖模型对数学的“理解”究竟到了哪一步。
数学和更多科学,都在被各大模型厂商当作下一个踏板,但探索从来不该沦为少数算力寡头垄断解释权的黑箱,面对AI暴力拆解出的黎曼猜想,每个人都有资格看懂它,这样人与机器的智能也会一起走向真正的下一站。
原文出处:虎嗅 (本文由聚合程序自动采集,版权归原作者所有)