对话Maxinsights:具身“卖铲人”的250倍增长、机器人Ego数据狂潮
(本文作者为 硅谷101,钛媒体经授权发布)文 | 硅谷101过去两年,在访问机器人公司时,我们听到最多的一句话就是:太缺数据了。当机器人公司们还在探索模型、算法、数据和部署的时候,一家并不生产机器人的硅谷公司,把机器人数据做成了一门年化收入数亿美元的生意。从100万美元到2.5亿美元,250倍增长,发生在短短一年。这…
(本文作者为 硅谷101,钛媒体经授权发布)
文 | 硅谷101
过去两年,在访问机器人公司时,我们听到最多的一句话就是:太缺数据了。
当机器人公司们还在探索模型、算法、数据和部署的时候,一家并不生产机器人的硅谷公司,把机器人数据做成了一门年化收入数亿美元的生意。
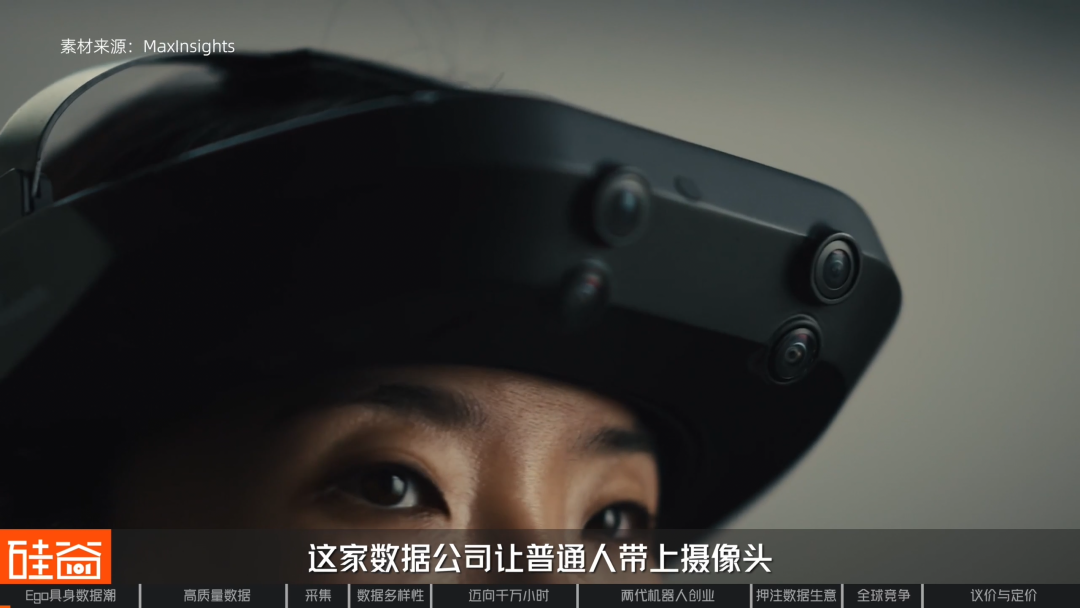
从100万美元到2.5亿美元,250倍增长,发生在短短一年。这家数据公司叫Maxinsights,它让普通人戴上摄像头,记录做饭、叠衣服、打扫卫生等日常动作,再把这些视频转化为机器人可以学习的训练数据。
如今,他们已经积累了200万小时的人类第一视角数据,并且建立起一张覆盖全球四千名数据采集人员的网络,而这家公司的数据采集运营团队,全职员工不到10个人。
我们在最近也访问了Dyna Robotics,这家硅谷机器人公司号称通过100万小时的人类第一视角数据,找到了机器人的scaling law(规模定律),而下一步,是1000万小时的数据。
当机器人行业开始验证自己的数据规模定律,这是否意味着,我们正在见证机器人领域下一个Scale AI的诞生?这篇文章,我们对谈了Maxinsights创始人袁宇光,从他经历的两代机器人创业潮说起,到当前机器人数据的商业模式、全球采集管理、数据技术,聊聊这场刚刚开始的机器人数据热潮。
陈茜:宇光,欢迎做客硅谷101。我听说你们现在是机器人行业里,数据业务收入最高的公司之一。你们主要的业务是什么?
袁宇光:我们主要做人类的数据,并且把人类的数据变成机器人可用的数据,帮助头部机器人公司训练自己的模型。
陈茜:现在具体的体量有多少?也就是硅谷现在说的ARR(年度经常性收入)。
袁宇光:我们的ARR(指的是2026预测年度经常性收入)差不多可以达到2.5亿美元左右。
陈茜:那今年增长应该非常快了。
袁宇光:是的,我们去年一年才差不多100万美元,到今年增长的速度非常快。这也跟行业发展有关,现在很多客户已经通过使用更多高质量数据,帮助模型训练,并得到了一些基本认知。
这些模型不仅有了更好的表现,而且使用了至少100万小时的数据。所以目前可以看到,Data Scaling Law(数据规模定律)在Physical AI(具身智能)里面已经实现了。
陈茜:过去两年,我一直听到机器人行业说缺数据。2025年大家说缺的还是遥操作数据,但最近我在硅谷看到,大家开始押注human-centric(以人为中心)的第一人称视角数据。
袁宇光:2025年和2026年确实发生了一些变化。2025年早期,客户跟我们一起去开发新的、帮助具身智能用更scalable(可规模化)的方式落地。
当时我们探索了很多数据类型,包括teleoperation(遥操作)、simulation(仿真)、egocentric data(第一人称视角数据),甚至做过手套数据。那时我们就发现,除了第一人称视角数据外,大部分数据要么难以规模化,比如遥操作永远有一个上限;要么落地时存在很大的差距,比如大家都知道的Sim-to-Real(仿真到现实迁移)问题。
当我们考虑规模化时就发现,如果能把每个人身上的特殊技能变成机器人的技能,想象空间就变大了。
2025年,作为这个行业里面最领先的人,我们第一个订单是200小时。那时候,200小时对我们来说还没有概念。
陈茜:是遥操数据吗?
袁宇光:不是,是第一人称视角数据。
陈茜:客户是谁,可以披露吗?
袁宇光:是美国头部的大模型公司。当时他们也在探索,我们一起试了很多数据类型,最后定在人类第一人称视角数据上。
主要有几个原因:第一是有用,第二是可以快速规模化,第三是还能把人类一些隐藏的技能,变成机器人新的知识和技能。把这些串起来就会发现,机器人将来想要实现真正的AGI,是可以把人的想法变成机器人的想法,并且予以实现的。
陈茜:人类隐藏的技能是什么?
袁宇光:就说现在很火的叠衣服,可能全球有成百上千种叠衣服的方式。如果把它们合并在一起,就可以让机器人用各种人类的方法去迭代,去叠一件很简单的衣服。
这样做的好处是,第一,可以让它叠得更有效;第二,可以叠得更可靠;第三,见到不同的东西都可以叠。所以我觉得,这给机器人本身增加了很多基础智能。
陈茜:相当于通过第一人称数据的方式,达到了它的泛化性。
袁宇光:是的。去年我们就已经发现,这些数据本身能增加模型一些简单的泛化性。
从最早的200小时,到去年年中、下半年加起来,我们一共有2万小时,相当于100倍的提升。到了今年年初,2万小时变成了20万小时。所以我们作为整个行业的一个先驱者,已经是走了三步。
在这个方向上,我们发现痛点也发生了变化:从缺数据,变成了缺高质量的数据。今天很多人还在说“我有很多数据”,但真正决定你能不能在行业里站住脚的,是数据质量到底有多好。
陈茜:先跟大家划清一下类别,你们采集的都是以人为中心、第一人称的视频数据?这些数据怎么采集?
袁宇光:是的,这种数据是来源于人们日常的生活,通过头部的设备进行采集。这是我们上一代的产品,而这是我们最新的产品,戴在头上可以记录整个手部的内容,而这种手部的内容会成为我们的毛坯数据,再经过我们的高质量处理管线,变成高质量数据。
陈茜:我看到上一代设备有六个摄像头,它有多大的视野?
袁宇光:270度。
陈茜:为什么要270度?
袁宇光:这也是我们最早积累的know-how(专有技术)。刚开始我们用GoPro,很小的摄像机。那时候我们收集的数据非常地真实且不可控,因为真实生活中,你的头会晃来晃去,手也会离开画面。所以我们用了270度的大范围视角,保证手至少在画面里,也能捕捉更多、更丰富的周围环境的信息给模型。
陈茜:两边各有一个,中间有四个摄像头,为什么这么设计?
袁宇光:中间四个主要拍到手,以及身体的一些部位,这些身体部位也可以给到模型提供更多的信息。以人为中心的数据不只有手,还有身体的位姿,所以会涉及pose tracking(姿态跟踪)和hand tracking(手部跟踪)。设备将来还要提供更丰富的信息,帮助模型做全方位跟踪。
陈茜:所以采集时,需要一位采集员戴着这个头盔。一天采集多少个小时?
袁宇光:我们的采集时间相对比较长。我们采用的都是相对专业的采集员和采集团队,这也是跟行业里不太一样的地方。现在很多公司有自己的外包采集网络,这很像当时Digital AI(数字智能)的模式:发动身边的人,让他们获得一些补充收入。
对我们来说,数据采集更像DoorDash,或者国内美团的模式。采集时,你需要大量、高质量,而且有多样性的数据,所以需要对采集团队进行直接管控。这种直接管控能帮助团队获得更高质量、更高的输出,才能在这个行业里获得更好的位置。
陈茜:这一块特别重要,整个数采团队的管理,我们待会儿可以详聊。先继续说数采设备,新一代相比上一代有什么区别和升级?
袁宇光:它更轻了,更轻,它的电池可以维持时间更长。
陈茜:感觉要小巧一些,甚至。
袁宇光:对,新的产品会更能快速地标定,就相对它得到的信息和结果会更准确。
陈茜:我看它只有4个摄像头。
袁宇光:对,4个就够了。
陈茜:那为什么之前要6个,然后现在只要4个。
袁宇光:其实也是迭代的过程。有更多的摄像头,大家就觉得会有更好的输出。但实际上我们也会考虑将来这个行业需要往成本优化的方式走,所以我们再去考虑得到更相同信息的前提下,要考虑更优化的成本结构。
陈茜:这两代摄像头的像素都一样吗?
袁宇光:对,类似。所以减到4个成本肯定是降低。
陈茜:那穿戴的体验,有没有什么区别?
袁宇光:这个是很轻的,而且它戴上的时候像帽子一样。然后你手机上会有一个APP,直接打开它连上就可以了。
陈茜:就是我看上看下看左看右,它就随着我的视线来动。
袁宇光:对,而且不管你怎么动,手部都不会离开画面。我们也希望通过硬件设计,让采集方式更容易规模化。
陈茜:特别有意思。那你们现在的体量是可以收集多少万小时的数据了?
袁宇光:我们一个月最高的产能可以收集到45万小时。
陈茜:所以你们现在手里面是有多少个小时的数据?
袁宇光:接近200万小时。
陈茜:这个规模在第一人称视角数据行业里,属于什么量级?是最多的吗?
袁宇光:是最多的,而且是相对高质量的第一人称视角数据集。
陈茜:你一直强调高质量。我也听机器人公司的研究员说,有些供应商号称有很多万小时数据,拿来训练却发现质量很低,根本没法用。怎样评判数据质量?
袁宇光:是的,质量本身也是不断迭代的过程。2025年刚开始,我们还没有清晰的质量概念,到今天已经有非常严格的质量管线,它会包含几个主要内容。
第一,tracking(跟踪)信息的准确度要高,达到毫米级。第二,数据要有足够的多样性,为模型提供更多样的数据。第三,还要有一定的量,每天只提供一小时,客户肯定不够用。这三个叠加起来,形成一个完整的数据包。
除了跟踪准确度里有很多language annotation(语言标注)的信息,视频本身也要包含有意义的任务输出。比如一直在玩手机,或者挠挠这里、挠挠那里,都不属于有效输出。有效的事件、准确的跟踪、准确的标注,把它们做成一个数据包,才是有效、高质量的数据。
陈茜:采集员戴着头盔完成任务、录下视频,你们收到之后,还要做哪些处理,才能交付给客户?
袁宇光:收集完所有毛坯数据后,要经过一条很长、很复杂的数据处理管线,最后才能交给客户使用。这一套管线出来的结果叫Training-ready Datasets(可直接用于训练的数据集),或者High-quality Datasets(高质量数据集),拿来就能训练。
而中间要对手部进行标注,要理解视频、进行语言标注,还要给整个视频做索引,归类它到底是什么。最后需要QC(质量检查),我们也会通过human in the loop(人工参与闭环)的方式验证数据质量。
陈茜:从原始数据进入管线,到成为可训练、可交付的数据,中间的淘汰率或筛选率是多少?
袁宇光:说实话,这个数字很难评判。因为很多筛选出来的数据,比如通过人工参与筛选出的数据,还会作为后续处理配方的一部分,回到管线里重新处理。我们会把数据的confidence level(置信度)分成不同等级,对应不同客户的要求,所以整个数据集也有不同分级。
陈茜:是不是有些客户要求很高,有些客户也能接受质量低一点的数据?
袁宇光:理论上,客户都需要高质量数据。
陈茜:低质量的数据给谁?
袁宇光:只是客户的要求不同。相对低质量的,我们更多叫General Datasets(通用数据集),会回到管线里重新处理。我们不会给客户低质量数据。
这些低质量数据能帮助我们重新认识,模型在标注过程中到底出了什么问题,以及数据管线应该怎样迭代。到今天,我们的管线已经迭代过差不多六七遍,这是行业里最重要的核心的部分。
陈茜:刚才提到遥操作、第一人称视角和合成数据这三类。第一人称视角数据,跟UMI有什么区别?
袁宇光:UMI数据是人手拿着夹爪,让它的形态跟机器人夹爪的形态对应起来,直接做retargeting(动作重定向)。UMI本身还会结合第一人称视角数据,现在比较流行的是这样一套方式。
第一人称视角数据是裸手的,没有任何夹爪,它们的区别就在这里。
陈茜:为什么要用夹爪?
袁宇光:这要看模型训练的三个阶段。大家知道pre-training(预训练)、post-training(后训练),现在还有mid-training(中期训练)。UMI会更多用在中期训练,甚至后训练里。
夹爪是目前更流行的方式,因为对于机器人来说,夹爪相对可靠,当然将来也会有很多灵巧手设计。我们的第一人称视角数据,不仅能对应夹爪,也能对应手。而UMI本身可以直接重定向到夹爪上,会更快、更有效。
陈茜:相当于UMI更适配夹爪机器人。如果我的人形机器人用的是五指灵巧手,就没必要用夹爪的UMI数据了。
那为什么要把第一人称视角数据和UMI结合?是希望训练出来的机器人,既能操作灵巧手,也能操作夹爪吗?
袁宇光:还是要看客户的机器人形态。有些偏向夹爪,就更依赖UMI;有些主要用灵巧手,那么直接从人手形态重定向过去会更好,因为两者更像。
陈茜:成本上有区别吗?
袁宇光:采集成本相差不大,主要区别在中间的数据处理管线。UMI的采集效率比裸手低很多。
陈茜:因为拿着工具去完成任务,肯定不如直接用手方便。
袁宇光:对,你做饭也不会用两个夹爪做饭。
用UMI采集,效率会低一些,但过数据管线时,处理会相对简单。裸手数据非常真实、不可控,会有很多边缘情况,所以管线需要处理这些问题。比如手经常被遮挡,有时看不到手,或者同一个镜头里出现多只手,比如我们在握手,都很难得到稳定的手部输出。
所以管线必须非常强大,才能提供高质量数据。
陈茜:目前客户主要在买什么数据?今年更多买的是human-centric(以人为中心)数据吗?
袁宇光:公允地讲,客户的数据训练配方里,有遥操作需求,有human-centric、也就是第一人称视角数据的需求,还有UMI需求。从我们目前的观察看,裸手第一人称视角数据的需求量最大。
你可以想象,不需要先变成夹爪这种中间形态,而是直接把人手变成机器人的灵巧手,像人一样下地干活,这多有想象空间。
陈茜:从成本看,遥操作最贵,仿真和合成数据最便宜,第一人称视角数据在中间?
袁宇光:理论上是的。但仿真数据,我们在2024年就研究过。因为仿真数据本身其实不是一个销售的产品,因为客户本身知道它非常便宜,可以生成很多,自己也可以做,所以它不是数据公司的主要方向。
仿真公司也有可以做的事情,比如环境、数据资产,这些是它们真正应该关注的。但就数据本身而言,我们认为目前从供应商购买的两个主要来源,一个是遥操作,一个是human-centric(以人为中心)。
陈茜:Human-centric(以人为中心)比遥操作要便宜多少?
袁宇光:不同客户有不同要求。如果从整个行业的发展来看,我认为可能便宜一半。
陈茜:我今年看到有一个趋势,很多世界模型公司、之前做视频生成的公司,现在都变成了机器人数据公司,也在向机器人公司卖数据。它们在这个环节里处于什么位置?
袁宇光:我们认为,很多世界模型公司也是我们的客户。它们需要相当多真实数据,才能生成数据,也希望跟我们合作。这类公司跟我们的生态位相互依存,反而会带来整个行业的提升。
陈茜:但它们买了你们的数据,再卖给机器人公司,会不会跟你们形成竞争?
袁宇光:是这样。在世界模型体系里,它们会基于我们提供的一些简单任务,做不同的泛化处理,最后进入整个数据闭环。在某种程度上,我们是相互依存的:我们提供更多原始数据,它们再生成视频,而我们可以继续用高质量标注产线,帮助它们把这些视频标注成处理后的数据,变成客户最终能用的数据。
陈茜:它们现在没有数据产线。如果将来也建了自己的产线呢?
袁宇光:假设这些公司有很多现金储备,今天想做数据产线,其实是在做我们2023年做的事情。刚才说过,我们大部分产线依靠模型,而这些模型的制作,需要Ground Truth Data(真值数据)。
我们有很多自己开发、研究的真值数据管线,这部分属于真正的Proprietary Data(专有数据),是任何人都没有的。所以,即使它们今天做,也只是在做我们2023年、2024年做的事情。
陈茜:有两到三年的差距。
袁宇光:对。所以我们认为,现在很多想做数据的公司已经入局晚了,头部已经产生了。
陈茜:这个差距没办法用其他方式赶超,因为这个数据产线是你们过去两三年积累的资产和护城河。
袁宇光:对,这是我认为数据公司一个重要的护城河。产线的结果是高质量数据,过程依靠不同模型,而模型又基于之前积攒的专有数据。这些专有数据的规模,我们认为已经达到行业相对领先的位置。
其他公司想再积攒,需要相当长时间。这些属于物理过程,不是直接就可以生成的数据过程。
陈茜:数据收集,以及收集过程的管理,也是护城河?
袁宇光:是的,数据收集及其管理都是护城河。数据公司需要一条很强的Vertically Integrated(垂直整合)产线,从硬件开发、运营,到数据管线,再到最终输出,整个链条都要连在一起。任何想卖数据的公司,都离不开这些。
刚才说的视频蒸馏公司,它们没有运营,也没有硬件。对于一个纯数据收集公司,没有数据产线,也没有那些专有数据。只有把这些连在一起,才能输出最高质量、最大规模,而且有多样性的数据。
陈茜:这大约200万小时的human-centric(以人为中心)数据,是多少人采出来的?
袁宇光:我们全球有接近4000人的采集团队,都是直接管理的。这个模式很像DoorDash,能帮助我们快速扩大规模、找到新场景,并采集到更高质量的数据。
陈茜:能不能解释一下这个DoorDash模式?
袁宇光:这种运营模式挺有意思的。今天包括Figure等公司,也在做外包网络。我们在2025年就试过外包的形式,但发现几个大问题:质量低、输出慢、产量也低。
在我们的理念里,运营就像工厂,只是它没有集中在一个地方,而是散布在各地。这更接近DoorDash式的直接管理:早期DoorDash会对骑手有更多管理,需要去哪儿、怎么做,系统都会直接给指示。
我们的运营团队是自建的,不太使用外部供应商。供应商的价值,是提供一些罕见、不常见的场景。而大量的自建团队,则能帮助我们快速进入想要的场景。
比如明天需要医院、养老院场景,可以直接向采集员下达任务,让他们进入这些场景,快速反馈回来。如果先找供应商,再让供应商安排,反馈闭环就会非常慢。这是快速迭代的行业,运营必须快速跟上要求,提供更高质量的反馈。
陈茜:自营听起来是个挺重的模式,需要怎样的管理经验?
袁宇光:挺难的,管理运营是一件特别难的事情。我们构建运营网络时,走了很多弯路。刚开始也用很多外部供应商,直接给目标,让他们采几万小时。
2026年1月,我们给出的目标是10万小时/月,如果低于2万就别干了。最后的成绩是18000小时/月。所以2月份进入调整期,我们觉得这种方式不行。我带着团队一点点看,怎样才能输出更多、更高质量的数据。
后来发现关键是以设备为中心,让周围的资源围着设备转,因为设备是唯一的资源。第一,设备要准;第二,设备要提升使用效率;第三,设备还要被正确使用。我们做的所有部分,都围绕设备本身拓展的。
刚才也聊到,我们一天能采集多少数据。在整个行业里,我们的设备使用率是最高的,所以这样才能帮助我们产生大量、高质量的数据,回到产线里继续使用。
陈茜:听起来,首先硬件要好,接着培训和管理都要到位。
袁宇光:同时还需要科技加持,需要一个平台。我们全球有接近4000名采集员,但管理这4000人的数据采集运营团队的全职员工不到十个人,这是一种非常高效的管理模式。
这种模式依靠的是中间这一层,叫AI Agent in the Loop(智能体参与闭环)的平台。它既能管理设备,也能管理人,还能帮助他们提高质量和数据产量。后端模型依靠我们大量的数据,直接给采集员反馈,甚至设备没戴好,agent也会提醒他们。
陈茜:Agent相当于一个“小监工”,盯着采集过程,随时反馈。
袁宇光:我们叫小助手。
陈茜:“小助手”这个名字好听一点。这4000名采集员分散在哪里?
袁宇光:我们分散在八个国家:美国,包括现在在的洛杉矶也有团队;还有墨西哥,东南亚的印尼、越南和泰国,中国、土耳其,以及最远的南非。为了管理这件事,我们还在印尼设了自己的办公室。
陈茜:4000人不算特别大的规模,为什么不集中在一个国家,比如印尼或巴西,而要分散到这么多国家?
袁宇光:这跟数据需求有关。模型需要更多样性的数据,理解来自不同地方的数据类型。不同国家有不同生活方式,把这些不同生活方式合在一起,才变成最后的智能。所以要去不同国家采集,每个人的生活方式不一样。
陈茜:比如做的菜不同,有法式菜、中餐,叠的衣服、生活方式和环境也不一样。
袁宇光:对,比如东南亚能见到很多长袖、戴帽子的,洛杉矶则有很多短袖。
陈茜:10个人通过agent去管理4000人,这个模式还是挺有意思的。现在可以透露一下客户都有谁吗?
袁宇光:客户分为两类。一类是大模型客户,就是你天天用的那些AI。因为一些原因,我们不能说具体名字。另一类是做Robotics Intelligence(机器人智能)的客户。
陈茜:大模型客户用这些数据,也是为了训练机器人,还是做视觉推理?
袁宇光:是训练机器人。
陈茜:所以Astra出来,它们肯定也用了很多机器人数据。
袁宇光:Astra这个方向特别惊艳。
陈茜:它出来之后,整个机器人行业都炸了。
袁宇光:我们也很兴奋。大模型使用很多第一人称视角数据和机器人数据,帮助机器人产生更多泛化性。
机器人公司看到变化,也开始思考:是不是真正要落地、做垂直应用,公司将来的方向是什么?我们希望帮助这两类客户,得到它们各自需要的基础设施,包括数据、评估和后面的落地,结合起来提供全栈支持。
陈茜:卖给这些客户的,都是同一套数据吗?
袁宇光:我们一直提供数据集的license(使用授权)。数据集每天都在不断扩大,所以每天都会不一样。
陈茜:我们前几天访问了Dyna Robotics。他们在Dyna-2发布时提到,用100万小时的human-centric(以人为中心)数据,找到了他们的Scaling Law(缩放定律)。这100万小时里,可能大部分都是从你们这儿买的,而你们也可能把其中七八十万小时的数据卖给其他客户。
从商业角度出发,机器人数据现在的模式会不会有一点像SaaS(软件即服务)?同一套软件可以卖给上千个客户。如果目前human-centric(以人为中心)数据总共就这么多,100万、200万小时,也可以卖给所有大模型公司和机器人公司?
袁宇光:数据对客户来说可以复用。如果一套数据集已经被一个客户验证过,它就很容易给其他客户带来相同、甚至更高的价值。所以我们也要不断提高对自己的要求。
陈茜:如果大家买到的是同一套数据集,对模型训练来说,数据本身就没有差异性了。
袁宇光:它们的训练配方不同。模型架构、模型使用方式都不一样。我想Dyna、Genesis、OpenAI,以及其他大公司,都有自己的一套训练方法。这是数据之外,它们自己的配方。
陈茜:所以,模型能不能更好地利用这些数据,是最终效果的差异点。后训练是不是也是?比如Dyna内部也会采集遥操作数据,用在后训练或RL(强化学习)中,这部分是它们自己要做的事情。
袁宇光:我们认为是这样。预训练、后训练、中期训练会形成反馈机制,让机器人更好地落地。我看到一个说法,99%只是一个起点。还有1%,需要通过后训练,真正实现部署。
作为数据合作伙伴,我们可以在后训练里提供更多不同价值。但这确实需要跟客户走得更近,了解它们的需求、帮助它们落地,才能做到。
陈茜:目前客户主要拿你们的数据做预训练?
袁宇光:目前是,但明天可能就不一定了。
陈茜:为什么?有什么不一样?
袁宇光:我们认为,行业变化很大。看到新的Astra 6出来,我们觉得基本泛化性的问题已经基本解决,但一些长程任务、更难的任务还解决不了,仍在提升。除此之外,行业也会进入下一个阶段。
我们认为明年有两个大趋势:第一,数据量继续扩增。我们自己的观点是,每家客户基本需要100万小时左右,作为保底的地板线,往上不设上限。不同客户有不同需求,但基本都是十倍增加。
在这个基础上,一些客户会进入后训练。这非常依赖具体环境,而我们的运营体系能快速提供不同环境、不同场景,帮助客户测试和评估硬件。不只包括模型,也包括硬件本身的可靠性。这也是我们跟客户越来越近的原因:不只是数据供应商,后面还包括模型反馈的供应商。
陈茜:我跟Dyna聊的时候,他们说现在Dyna-2完成100万小时之后,接下来想再验证1000万小时的量级,看Scaling Law是否还能立得住。如果成立,可能说明路线是对的。
行业往1000万小时的human-centric(以人为中心)数据迈进,对你们是很好的机会,但竞争也会更多。什么时候能达到这个规模的训练集?一年能完成吗?
袁宇光:我觉得可能都不需要一年。这就是为什么要建立足够灵活、能产出高质量数据的团队。
从100万到1000万小时,十倍提升,是对运营最大的考验。像外包网络,一个人一天可能也就产出一两个小时数据,要多少人才能满足1000万小时的需求?
陈茜:如果你们要产出1000万小时,需要多少人?
袁宇光:我估计需要现在基础上3到5倍左右的人。
陈茜:现在是4000名采集员,可能要到2万人?
袁宇光:差不多在1.5万到2万人左右。
陈茜:对公司的挑战是什么?
袁宇光:我们永远在看怎样快速扩大规模,这对公司成长非常关键。最大的挑战有三点:
第一,能不能保持数据质量的同时增加数量,还能保证多样性。这三个放在一起,要看管线够不够稳健可靠。如果每天只能产生一两个小时,我认为无法满足行业需求。
第二,在这么多行业、这么多国家运营,能不能快速转换?
第三,在前两点的基础之上,能不能理解客户对1000万小时的具体细分要求?这些要求可能不止一个,还会根据客户自身需求不断迭代,你怎样跟客户紧密协作?
目前我们有三十多个客户,每个客户对数据需求都有不同想法。我们也会反过来建议,数据应该怎么做、往后怎么走。从100万到1000万小时,需要跟客户持续沟通数据迭代的过程。我们非常愿意成为行业的一部分,帮助整个行业像飞轮一样转起来。
陈茜:如果类比大模型数据,Scale AI最初的采集成本没那么高,但模型能力越来越强,就需要硕士、博士标注高质量科研数据,成本也越来越高。
机器人数据会不会也是这样:通用、泛化性较强的场景相对便宜,但垂直专业场景的成本会很高?
袁宇光:我认为Physical AI会跟Digital AI走一样的路线。今天Scale AI、Mercor等公司都在提供更多数据给大语言模型,具身智能将来也会这样。
2025年最初的200小时基本不设限,什么都可以。到了下半年采几万小时,任务要求还很简单,做些简单事情、搬动东西就行。到今天,要求确实越来越难。它不再需要数据工厂里的模拟场景数据,也不再需要简单的“擦擦擦”。
陈茜:什么叫擦擦擦?
袁宇光:比如擦桌子、擦玻璃,这就叫“擦擦擦”。现在也不再需要简单地把东西摆来摆去。
和Digital AI一样,将来会需要越来越难的数据。一类帮助大模型继续提升,另一类满足落地型客户的需求。比如客户要去养老院,就不需要医院的数据,而是希望全球不同地方的养老院一起帮忙测试。怎样把成功率从99%提高到99.99%,才是我们提供的价值。
目前我们有三十多个客户,我们认为是行业里客户数量最多的公司之一。同时,ARR(指的是2026预测年度经常性收入)差不多能达到2.5亿美元。行业扩张确实带来了很多欣喜,但也带来了很多困扰。
陈茜:困扰是什么?
袁宇光:困扰是怎样尽可能快地规模化提升数据质量。从200小时到200万小时,甚至将来1000万小时,需要的基础设施是不一样的。
比如上传网络怎样设置更省钱?怎样更好地标注?现在还有很多业内人士用大模型做文字标注,太贵了,会花非常多钱。所以我们做自己的模型,既为了省钱,也为了提高质量。
另外,怎样把人的活动连接起来,让他们形成一定网络,还能保持大规模、高质量,这件事很难,这是我们在考虑的下一步。
陈茜:大语言模型已经穷尽互联网上的人类语料和数据,机器人的数据会穷尽吗?因为机器人数据不在互联网上,而是采集出来的。从100万小时到1000万小时,它的上限在哪里?
袁宇光:我认为会,但也要看数据类型。遥操作的上限相对较低,到一定程度,量就够了。第一人称视角数据的上限更高,但到一定程度,也会进入平缓期。
陈茜:为什么会进入平缓期?
袁宇光:平缓期是指,在相同模型架构的前提下,继续增加这些数据,对成功率的提升已经非常有限。
再下一步,就要看你想用模型做什么。如果觉得99%可以了,可以去做更难的任务,但更难任务的提升也会很慢。另外,如果要从99%提高到99.99%,就需要更多、更专业的数据。
所以我们认为,将来的运营网络会从普通人都可以戴的设备,发展成专家式的网络,帮助客户更快跨过99%到99.99%的平缓期、更快落地。人形机器人最终要商业化,更快执行一个应用、真正落地,才能更快收回成本。谁能帮客户更快落地,谁就能赢得信任和订单。
陈茜:如果数据增加到一定程度,对模型的提升有限,或者说曲线变得平滑,那你们这类机器人数据公司的价值还在哪里?
袁宇光:在后面。数据只是切入点,落地时还需要评估和部署。这种评估和部署在Digital AI时代里是没有的,需要在实际生活里做物理尝试。
比如模型做好了,最近Physical Intelligence发布了API,你要测试:第一,它到底在哪些地方、哪些场景、哪些情况下会失败?第二,失败后,能不能帮助它恢复?恢复的过程,又会成为更宝贵的数据,帮助模型提高泛化能力和成功率。这些是数据公司可以做的。
再往后,想象沃尔玛、Costco使用人形机器人时,需要的是全栈支持,不仅包括落地,还包括数据。那时数据合作伙伴也很有想象空间。当把数据生产产线、运营网络,再加上部署和评估平台结合起来交给客户,这时候比如Costco、沃尔玛就可以使用这一套产品,真正落地,就像今天使用ABB、库卡的工业机器人一样。
陈茜:所以最终的愿景,是做全栈服务商。
袁宇光:是的,我们也在往这个方向发展。数据带来的是高质量、大规模的数据处理能力,这是深的能力;运营是广的能力。两种能力叠加,再跟客户共同迭代,形成与客户协作的能力。
这三种能力放在一起,三位一体,才能在Physical AI领域走得越来越远。这是我们不断打造能力、考虑更长远发展时在做的事情。
陈茜:从数据的角度看,你觉得什么样的机器人公司最后能够走出来?
袁宇光:我们希望每一家客户都走出来。
陈茜:所以都来用你们的服务、买你们的数据。
袁宇光:我们真的希望每一家客户都走出来,也是抱着这样的信念在做。我来自传统机器人领域,工业机器人很可靠,但很多人在做编程,其实是人在为机器人服务。
我们希望大模型公司提供更高的泛化能力,也希望这些与我们合作的、行业内有名的具身智能公司,真正进入它们能做的每一个场景。看到那一天,我会非常欣喜,不管我们在行业里是什么位置。能够为行业发展尽一份力,就是我们想看到的未来。
陈茜:接下来聊聊你的创业经历和来时路,帮助大家理解你为什么会选机器人数据这个方向。你从交大毕业后去了伊顿,后来进入机器人行业、自己创业。当时为什么选择伊顿?为什么想做机器人?
袁宇光:当时有很多offer,但那是很多很多年前了,我只是长得比较年轻。
交大毕业后,我当时也接触过Accenture,以及一家咨询公司Booz Allen Hamilton,后来拆分成Booz Allen和Hamilton,是全球除了麦肯锡、BCG、贝恩之外的第四家最大的咨询公司。
但我不是特别喜欢做演示报告、做分析,还是希望能动手、去尝试,所以选择进入自动化公司伊顿。这是一家五百强左右的企业,给了我很好的机会。我去过美国、墨西哥、日本,这些经历对现在的影响非常大,给了我全球视野和经验。
陈茜:伊顿当时主要做什么业务?你担任什么职位?
袁宇光:伊顿比较有名的项目之一,是国内C919的动力总成。它也是美国很大的电力供应商,有点像西门子、施耐德。比如我们这栋楼的电力系统,应该就是伊顿的。
我做过很多职位,产品经理、供应链、市场经理、销售,几乎把非技术的角色都做了。对我影响最大的,是在日本工作的四年左右,接触了很多生产体系,其中最有名的是丰田生产体系。这是一种质量管控体系,怎样在上量时控制质量,把两边平衡好,我把这些用到了今天的运营里。
陈茜:丰田的体系是什么?
袁宇光:丰田的体系叫TMS(丰田制造系统),也有其他日本名字。它分为几个部分,但大部分讲的都是质量:怎样在快速上量的同时保持质量?
比如生产汽车有一种流程叫PPAP(生产件批准程序)。上量的同时,质量必然会受到影响,所以要控制上量,再提升、再控制。我们管理运营时,也把它看成一个工厂,只不过这些工厂不在一个地方,而是在全球各地。
它背后的理念,就是First Principle(第一性原理),第一性原理是不变的。上量时,质量必然会受到影响,所以要控制质量,压下来,到一定程度再调整、再控制。这样才能在短期内,不断得到大量、高质量的输出。
陈茜:下压的过程中,会遇到什么挑战?
袁宇光:很多挑战。不同场景有不同要求,比如具身智能采集中,会有很多无意义的任务:玩手机、走路、手离开画面、跟人聊天。还有设备佩戴不对的情况,有的人喜欢这样戴。
陈茜:镜头就直接对着天花板了。
袁宇光:像这样戴,数据怎么处理?还有很多边缘情况,怎样通过管线处理?场景又能不能持续保持多样性?
我们发现过,一个房间四个角各放一张桌子,四个人采四份数据,衣服叠完了放、放完了再叠,效率最高。但这对我们的管理不利,对客户的泛化性也不利。我们用很多方法去掉这些问题,最后输出的才是真正的高质量数据。这些细微之处,客户是不知道的。但我们为管理这些数量和质量问题,花了大量精力。
陈茜:这些来自你当年在伊顿的经验?
袁宇光:确实是在日本跟生产体系学到了怎样生产。只不过现在不是在一个地方,而是在全球各地生产。
陈茜:2014年左右,你为什么决定离开伊顿创业?
袁宇光:想做一只自由飞翔的鸟。2014年出来以后,我最大的感受是,原来自己像笼子里的鸟,被喂得挺胖、挺好,别人给食吃,但永远在笼子里。飞出来后,才发现世界很大,有很多有意思的感受,也很好奇。但有时候找不到食吃,这也是那时挺痛苦的地方。
陈茜:你创办的Mega Gear Robotics,当时做什么?
袁宇光:做机器人。我们想做自己的低成本机器人。2014年,十二年前,ABB、库卡、Yaskawa(安川)、Fanuc(发那科)这“四大家族”,加起来占中国90%以上的市场份额,跟今天截然相反。我们觉得这是机会,想做自己的机器人,替代头部企业,就是这么简单的想法。
陈茜:你当时觉得他们做得不好,还是觉得他们太贵了?
袁宇光:太贵了。按今天的价格看,那时差不多是现在的2倍、2.5倍,甚至3倍。
陈茜:当时做的还是大型机械臂、工业机器人,并不是人形机器人。
袁宇光:对。那时还没有今天熟悉的节卡(JAKA)、埃里特等协作机器人品牌。最初我们也做得不好,做了一台裸机,外壳都没装,线露在外面。做下一代产品时,想把它当废铁扔了,但我觉得这样不行。
后来遇到一位大学老师,他说有些预算,我就问能不能用在我们身上,他问我们有什么。2014年,我刚看到“开源”这个新词,就说这台机器人是开源的。他愣了两秒,问什么叫“开源”,我说“就是你可以随便改”。他觉得挺好,因为大部分工业机器人只能编从A到B,没办法编太底层。我们的机器人可以编到底层,满足了很多大学、技能学校的需求,帮助学生提升对机器人本身运动学的认知。
陈茜:相当于宇树现在的生意:提供本体,让大家在上面编程。
袁宇光:是的,变成了一个小的开源平台。当时销售还不错,我也觉得挺好。
陈茜:你当时卖多少钱一台?
袁宇光:接近20万元人民币。
陈茜:这么贵?
袁宇光:那时候算便宜的。相同负载下,ABB、库卡还要高20%到40%。
陈茜:“四大家族”已经占了这么大的市场,你为什么有信心,觉得自己能做得比它们好?
袁宇光:那时候没有自信,就是试试看。我不是想做鸟吗?飞出来以后,得先找东西吃再说。我们一直在探索,试过很多方向,从机器人做起,后来做到了这部分。
开源机器人虽然有很多学校客户,但宇树走到今天,是因为它一直坚持,并不是所有人都看好教育行业。所以后来我们又从硬件转到模型、计算机视觉,用很多图片做了一个小模型,才真正走出来。
陈茜:但那时的模型跟今天肯定完全不一样。
袁宇光:不一样,但也有相同的地方。那时候模型很小,难的是取得数据、取得高质量照片。我们当时做的一个产品需要不断拍照。拍照看上去很容易,但产品本身有不同特性。我们的目的是,用一种特别的方式,准确把它夹起来,放到同一个很精确的位置上。这需要了解产品形态,而形态有上千种,对我们很难。所以那时候,我就开始对数据有一些认知了。
陈茜:后来为什么把公司卖了?
袁宇光:这是创始人一个好的出路。我觉得创始人有三种出路:上市、卖公司,或者让公司非常盈利。这给了我今天做企业的一些感受:要以终为始,先想最终怎样做,再回到今天。
那时候没有这个想法,是从始终,看到方向,先做再说,就像在黑森林里,看不到任何东西,不知道往哪走。所以给其他创始人的一点建议;先想商业模式是什么、怎么盈利。别像我一样,先打开笼子飞出来。没有食吃,瘦了一圈,才挣扎着看清世界,那时候挺痛苦的。
陈茜:是不是当时觉得市场也就那样了,因为高校教育市场本身比较小,当时大家对机器人软硬件的认知,也还没准备好?
袁宇光:是的。2014年甚至更早,二零一几年的时候,这个行业一直很难发展。当时没有具身智能的概念,大部分在讲“工业4.0”,还记得这个词吗?
后来我们又试了很多方向,大概转型六七次,包括工业互联网、IIoT(工业物联网),把机器人连接起来,做能联网、监控的平台。
后来为什么不做了?因为商业模式不对,收不上来钱。我们很快铺了几个工厂,能监控几百台机器人,但客户不愿付费,就只能转型。
陈茜:不愿付费,是因为没有看到价值?
袁宇光:我认为那时还没有到那个付费习惯。痛点和痒点很难区分,客户告诉你“我需要”,很多时候只是痒点,挠一挠就行了,不愿意付费。真正的痛点,才会让客户持续付钱。
有句话说得很好:当你的产品不完善,几乎不能用,只有核心功能时,客户还愿意付费,那才是真正的痛点。
陈茜:当时客户告诉你,他们的痛点或痒点是什么?
袁宇光:我当时根本没问痛点是什么。我带着一个小团队,把大家关在屋里,说咱们打电话给这些人,给他们装上,他们肯定有需求。
我假设他们有这个需求。我问了两个朋友,他们说“有,可以试试”。但他们的第一句话,我当时没有真正记在心里,现在才有感受:他们在回答有没有需求之前,先问的是“这事要不要收钱?”我说“不收钱,先试试”,他们就说“好,试试就试试,挺好”。
但上量以后,发现他们真正的付费意愿比较低。
陈茜:如果当时说要收钱,可能就不想试了。
袁宇光:下一个问题可能就是“收多少钱”。而且很多时候,我问的人不是最终决策者,甚至说愿意付钱,都不一定是真的。
这给了我很多今天的感受,包括这次创业之前,我咨询了大量的人。2022年,我有了再做一些事情的想法。2023年,看到机器人叠衣服,我觉得行业要变化了。这跟过去ABB、库卡那些大型工厂、车间里的机器人完全不同,需要一种全新的、处理柔软物体的能力。
看到叠衣服,我觉得接下来肯定会发生什么,但又不确定。于是向UC Berkeley和自己的关系网络,发了大量陌生拜访邮件,咨询了接近200人。
陈茜:当时你在伯克利念书?
袁宇光:在伯克利念MBA。
陈茜:是把之前的公司卖掉后,去伯克利的?
袁宇光:是的。我在伯克利发邮件,几乎给机器人行业的同学都发过。最初回复率很低,只有10%。后来不断改进写邮件的技巧,提高到了40%。
陈茜:那时还没有ChatGPT帮你写邮件。
袁宇光:对,都是自己写。每周差不多安排两个会,不断问他们的想法。这些人里,有些今天成为客户,有些成为竞争对手。生活就是这么有意思。
陈茜:伯克利是个很神奇的地方。我觉得你毕业的两所学校,在这一轮AI浪潮里都很重要。交大不用说,硅谷很多核心研究员、创始人都是交大毕业的。伯克利也一样,比如机器人领域的Chelsea Finn、Sergey Levine、Pieter Abbeel,都是教父级、教母级人物。伯克利的机器人行业氛围是什么样的?
袁宇光:伯克利、斯坦福,学术合作都非常紧密,整个湾区作为一个整体,大家都是机器人的信仰者,相信人形机器人、相信机器人领域的AGI。所以说这种信仰,把大家聚集起来。
我当时跟他们聊,也在想这种信仰是什么。逐渐融入这种氛围,再同频交流,才有了今天的Maxinsights。公司的所有基础,都来自那个时候很早期的认知。
今天大家都知道数据是瓶颈,但回到2023年,很少有人有这个认知。从当时的非共识到今天的共识,我们把赌注放到桌上,把所有精力放到桌上,变成真正的筹码。这跟整个行业和整个学术的氛围是离不开的。
我们公司有学术人才,也有工程师,彼此结合很有意思。既要发展前沿技术,又要帮助它规模化,这才是将来的核心。
陈茜:这一轮吸取了上次的经验,一定要找到足够痛的痛点。你确实也找到了机器人行业的痛点,就是数据。当时你创业的时候,为什么这么笃定?
袁宇光:这件事有两个大的认知。第一个是同类对比,Physical AI有无人驾驶这个先行者,还可以参考Digital AI,它们都离不开数据。过去获取数据的方法,跟今天很相关,可以参考。
第二个是另一个维度,是找到真正的决策者。可能就是带动行业前沿技术发展的研究人员,他们说的话,一顶一地重要。所以我当时聊一个人就很兴奋,天天聊都不觉得累,反而精力充沛,因为得到了更多知识,知道行业会怎样发展。
我觉得我们的工作也是这样,包括很多VC公司也是。这些是我当时得到的基本认知,但那时完全是自发的,只有我自己发邮件,到今天发件箱里还保存着那些邮件。
从这两个角度交织在一起看,我认为行业正在变化,再加上2023年看到机器人叠衣服的结果,这些合起来,成为我往后发展的动力。
陈茜:你现在押注机器人的Scaling Law。虽然之后想做全栈服务,但这件事的上限,也决定了目前能卖多少数据。

袁宇光:我认为是这样。但行业边界在于Physical AI到底有多大,真正部署人形机器人的机会有多少。客户可以做智能、做部署,但真正部署时,需要很广的输出、很深的认知,这是我们提供的价值。
所以它不仅由数据的上限决定,也由整个行业的边界决定。我们笃定Physical AI的上限会远大于Digital AI,这是我们真正押注的现实和未来。
陈茜:你们是这一轮“卖铲子”的人,但这听起来好像没有做机器人本身那么sexy,你能接受吗?
袁宇光:每个行业都有自己的角色,要从自身优势和能力出发。我们团队结合了工程化与研究,也包括我个人的经历。你让我真的做AI深入研究,我做不了。
但我能做的是,让整个行业的基础变厚,帮助客户快速扩大规模。我的所有经历,都在告诉我怎样规模化,包括在日本的运营,以及后来工作中怎样寻找新机会。上一家公司,我花了大量精力寻找部署机会。把部署经验和运营经验结合起来,就是我在这个行业里能提供的更高价值。
陈茜:你对数据公司的门槛很有信心。但中国、东南亚一些公司的成本,可能只有在美国做的几分之一,甚至更低。你怎么看未来数据之间的竞争?
袁宇光:要看一小时数据的成本结构,其中很大一部分来自运营,另一部分是云,此外才是其他成本。刚才说的人员、G&A(一般及行政费用)、R&D(研发)等,摊销到每小时数据里,占比很小。
我们有三个办公室,硅谷、苏州、印尼,分别为公司提供不同价值。我们核心在硅谷,不断地提升前沿技术,以及数据管线里的多个模型;外围办公室提供运营管理,美国也有全球管理;中国更多提供工具开发能力。
对比东南亚、中国的一些公司,它们相对更具地域性。就像Uber全球运营一样,我们的愿景也是全球运营,以美国为基础,发展到中国、欧洲,不局限于一个地方,这才是整个客户体系。
陈茜:亚洲公司也可以设全球办公室。你们在硅谷,是不是也有地缘政治因素:美国机器人公司更倾向采购美国数据公司的数据?
袁宇光:理论上是的。作为美国公司,我们离美国客户更近,能提供更紧密的服务、更快的迭代。
将来我们还希望在欧洲设办公室,跟欧洲客户持续迭代。客户服务需要不断加快反馈机制,这对后面的评估和部署也有帮助。
陈茜:冷启动时,机器人数据、尤其human-centric(以人为中心)数据还没有爆发,增长也没那么快。你怀疑过这次的路线是否正确吗?
袁宇光:行业发展中,你会不断自省。不是怀疑,而是去确定,事情是不是在正确方向上。那时,我认为数据的大方向基本确定,行业发展离不开模型架构、云、数据这三个要素。
数据是我们不断迭代、发展的重要方向,但数据本身又有不同分层,那时还有很多人在讨论仿真数据。当时仿真数据看上去很吸引人,也很容易规模化。
陈茜:这也是英伟达的一条主要路线。
袁宇光:对,其他公司也在用仿真数据。我们不评判仿真数据究竟怎样有用,但从销售角度,它很困难。客户能自己生成,数据就会很廉价。
我们也研究过遥操作在行业里的方向和影响。刚开始真的是车库创业,我和合伙人在他家车库摆了一套设备,做遥操作、接订单,接完回来继续研究。但确实碰到了很多困难。设备可靠性差,要找维修技术人员,运营效率也很低,而且越简单的任务,效率反而越低。这可能反直觉:简单的抓取、放置需要复位,如果复位时间跟操作时间一样,有效率最高就是50%,超不过去,一天的输出就那么多。
我们才有了新认知:遥操作确实很难规模化,也不适合我们的团队,所以继续找新方案。不断复盘,才能找到新方向,继续提高。
短期内,继续增加数据仍然可行,我们看到明年客户的基本需求,差不多都有十倍以上增长。但还要往下一步走,有部署、有评估,跟客户走得更紧密。还是以终为始,终点一定是人形机器人在某些场景里落地。落地需要评估模型,需要更多后训练、中期训练,甚至预训练数据。把它们合在一起,就是今天要准备做的事。
陈茜:做这些事情,目前最大的挑战是什么?
袁宇光:最大的挑战还是规模化提升数据质量。这是核心,背后有很多因素支撑。
首先,管线要更灵活,运营也要更灵活。单纯增加到一万人,怎样控制产量?如果需求变化,一万人天天消耗现金,这不行,所以必须灵活。
另外,怎样复用今天的数据质量和运营能力,把它们结合起来,变成真正给客户创造价值的部分。
陈茜:现在大家都看到数据行业是个香饽饽,都进来了。我听说有一些比较灰色的地带,比如有“数据二道贩子”,自己采集能力不够,就买别人的数据打包,凑成似乎很大的量,再高价卖给客户。你怎么看?
袁宇光:我们非常反对这样的事情。在我们的认知里,这个行业没有代理商。一份数据复制过来,就做更多销售,对数据行业会产生很不好的影响。
我们有一个词叫“数据纯度”,越纯,说明你拥有数据的能力越高。我们的数据纯度是百分之百,都是自己采的,全部由我们拥有。我们听到有些公司买其他外包商的数据,也听到有些公司在其他国家使用代理商,这种方式很难持续。
全球公司要有全球视野,清楚自己笃定的核心判断、商业模式是什么。首先要拥有数据,做好垂直整合,然后在拥有的同时,快速转化成客户的要求、保持标准。这才是规模化提升数据质量的最终结果。
陈茜:未来一年,你觉得硅谷机器人行业会怎样发展?
袁宇光:我们认为会发展得更快,实话实说。
陈茜:数据也会快速上量。
袁宇光:是的。看到客户需求,就能反推现在要做的事。两者连起来,你会发现客户接下来要做的事,让我们非常兴奋。我们认为明年具身智能会进入新时代,不仅有数据需求,还有更多落地和垂直应用。
身处上游、行业头部,看到的不是一两个客户,而是整个行业的变化。我们的客户几乎涵盖了所有这些品牌,我们也希望跟客户一起迭代,把最好的产品带到市场上。
陈茜:你们如今的议价权高吗?
袁宇光:产品价格在于提供的价值,而价值需要跟客户一起迭代。我们与客户变成了一种合作伙伴关系,原来叫Data Vendor(数据供应商),现在叫Data Partner(数据合作伙伴)。
跟客户一起迭代,走得越来越近,议价权已经不重要了,重要的是产品真正提供的价值,有没有体现在价格里。我们一直坚持的数据质量,能不能真正帮助模型提升,这才是要做的事。
陈茜:议价权重要,议价权意味着利润。就像GPU,因为稀缺,所以有高议价权。如果未来一年竞争多起来,议价权就不得不下降。
袁宇光:我们认为,行业价格基本是平稳的,没有特别多变化。只有一些新、小供应商,会用极低价格进入。
陈茜:有点打价格战的意思。
袁宇光:但客户不买单。一个供应商跟你合作很久,提供大量高质量数据,客户看的是,它到底能不能提升更多价值,弥补成本。这笔账,客户是算过的。
用了非常低价、质量不好的数据,计算成本反而更高。如果模型退化,还要重新训练一版,就不只是买数据的问题了。所以数据合作关系会越来越紧。
陈茜:当数据量上去之后,单价和成本是不是也能降一些?
袁宇光:数据量上去后,会进行分级定价。
陈茜:怎么理解分级定价?
袁宇光:现在流行的大部分还是手部数据,大家放的演示也主要是手。以后会有upper body(上半身)、whole body(全身),还会有手套等不同方式。
陈茜:具体怎么做?从第三人称拍机器人吗?
袁宇光:有些从第三人称,有些第一人称就够了。我们有不同生产方式、不同管线,所以要用不同设备,才能更有效地生产数据。也包括不同模态,比如力控、力觉的感受。这是我们做的手套,表面有很多bending sensor(弯曲传感器)。
陈茜:外观看起来跟普通手套差不多。
袁宇光:湾区可能用不太到,但在比较冷的地方,能看到很多这样的手套。它很柔软,手心、手掌和手背都有弯曲传感器,用来收集力的数据。
陈茜:它采集什么数据?
袁宇光:力、tactile(触觉)这一类数据。
陈茜:手指上也遍布传感器。这跟我在国内看到的触觉传感器不太一样,它们直接做在灵巧手上,感觉更复杂一些。
袁宇光:有些原理一样,也有区别。最难的还是规模化,同时保证可靠性。这些数据也会成为刚才说的分级定价的一部分。新的数据种类、新的数据形态,会决定不同定价。所以数据量虽然上去了,平均价格没准还会上升。
陈茜:自动驾驶因为极端情况、安全、监管等问题,落地比我们预想中晚了很多年。机器人也会这样吗?如果也晚很多年,对你们意味着什么?
袁宇光:无人驾驶是在车的基础上提升智能,难点是很多极端情况、安全问题。真正在路上发生交通事故,非常困难。早期Uber自动驾驶出过问题,后来卖掉整个部门,现在又重新做。
原文出处:钛媒体 (本文由聚合程序自动采集,版权归原作者所有)