姚期智、杨植麟联合署名论文:9个前沿大模型,如何证明人类数学极限?
AI能当理论计算机科学家吗?姚期智和杨植麟共同署名的论文给出答案。如果把理论计算机科学比作数学界的“奥林匹克”,那它研究的不是怎么修电脑,而是计算本身的上限:哪些问题算得快,数学证明的极限在哪里。现在,一批前沿大语言模型,包括ChatGPT在内的这类AI大模型,也来参加这场“奥林匹克”了。11月9日,澎湃新闻记者获悉,…
AI能当理论计算机科学家吗?姚期智和杨植麟共同署名的论文给出答案。
如果把理论计算机科学比作数学界的“奥林匹克”,那它研究的不是怎么修电脑,而是计算本身的上限:哪些问题算得快,数学证明的极限在哪里。现在,一批前沿大语言模型,包括ChatGPT在内的这类AI大模型,也来参加这场“奥林匹克”了。
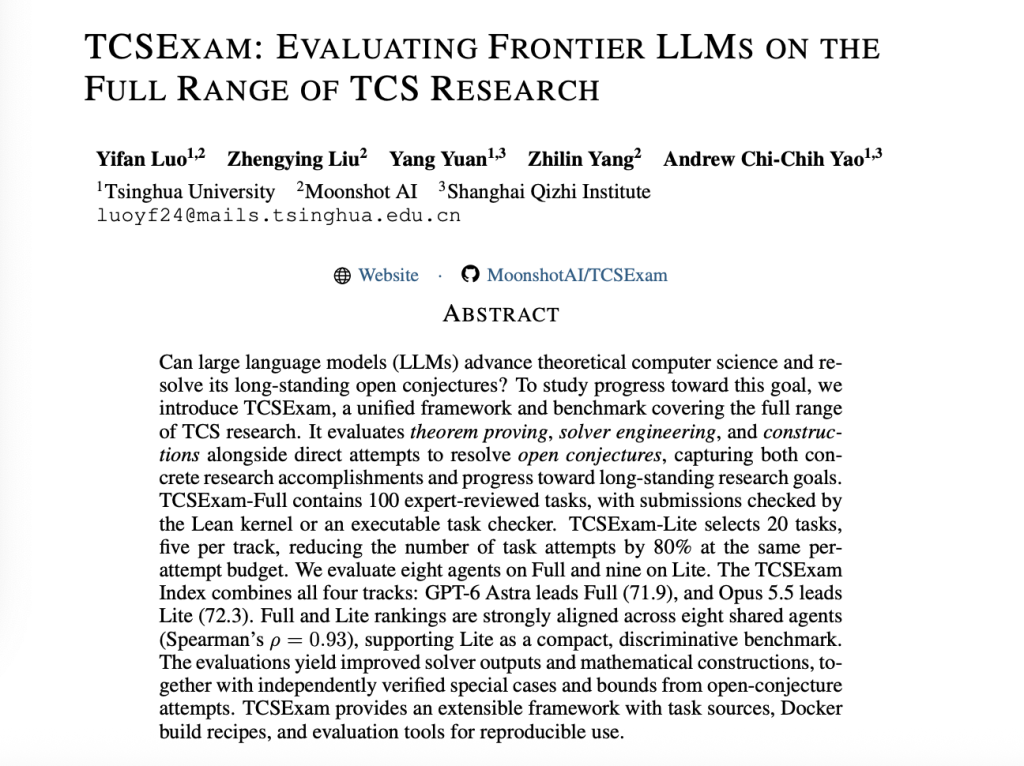
11月9日,澎湃新闻记者获悉,近期图灵奖得主、中国科学院院士、清华大学交叉信息研究院院长姚期智团队,联合月之暗面(Kimi)创始人杨植麟等发表署名论文:《TCSEXAM:在TCS研究的全范围内评估前沿大型语言模型》。论文中推出一个叫TCSExam的“统一考试”,称第一次把理论计算机科学研究的完整链条都纳入评测。
论文中对于大模型共设了四类考题,每类都有机器验算,给世界范围内九个前沿大模型出了一张理论计算机科学的“考卷”:
第一类,定理证明:给AI一道研究级数学定理,让它写出严格证明。证明要用一种叫Lean 4的软件写成——可以理解成“数学作业的自动批改器”,只认逐行严格的逻辑,不认含糊表述。批改由Lean内核完成,相当于机器逐行验算。
第二类,求解器工程:不是让AI针对一道题写死答案,而是让它写一个“通用解题程序”,然后拿大量具体测试数据去跑。比如给一堆图,让程序找出最大的团、最好的切割方案。程序必须能重复使用,不能靠背答案。
第三类,构造:让AI交出一个具体的数学对象,比如一张图、一套编码、一种几何排布,还要附上“证书”,也就是证明这个对象确实满足要求的凭证。机器会检查对象和证书是否都对得上。
第四类,开放猜想。给AI几十年没人证明也没人推翻的数学难题,要求它完整证明或完整反证。反证就是举出反例并证明这个反例确实推翻了原猜想。
在最受关注的定理证明类,GPT-6 Astra在“裸考”条件下:只给主定理,不给中间引理,20道题完整证明出14道,成功率达到70%。Kimi K3.1 Pro以38.3%位居第二,其余多个模型只有个位数甚至零成功率。
论文还发现,如果给AI“递小抄”:补充中间引理和证明思路,成功率会明显上升。Kimi K3解出的定理数从3道增加到7道,DeepSeek V4.1 Flash从0道增加到6道。这说明AI不是完全不会推理,而是需要更好的“脚手架”。
在构造类,AI则不只追平人类记录,还出现超越。
Kimi K3造出一个124个顶点、630条边、既没有三角形也没有四边形的图,超过论文引用的629条边参考记录;它还造出一个量子纠错码,把最小距离从5提升到6。GPT-6 Astra则证明了一个二进制编码的上界:长度22、最小距离10的编码,最多只能有82个码字,改进了此前发表的84。论文同时提醒,这些“超纪录”要经过独立核验,而且评分函数会放大或压缩数值差异,所以还同时报告了原始数学参数。
最戏剧性的是开放猜想类。30个长期未解猜想中,只有6次提交被接受,而且全部来自AI通过网络检索到OpenAI已公开发表的Ryser和MIRUP反例,再改写成考试要求的Lean证明。换句话说,这不是AI“独立想出来”的,而是“查资料查到的”。论文直言,未来应该在断网条件下评测当时仍然开放的猜想。其余28个猜想没有任何完整解决。
不过,失败尝试并非毫无价值。GPT-6 Astra在攻Alon-Jaeger-Tarsi猜想时,独立证明了该猜想在一个有限数域上对所有不超过9维的情况成立,把此前不超过8维的已知范围推进了一步,并经过Lean独立验证。论文还报告了另外四个可独立验证的局部结果。这说明AI攻大猜想虽然解不了“大Boss”,但能顺手打出一些有价值的“小怪”。
根据论文推断显示,前沿AI已经能在研究级定理证明、构造优化和求解器工程上做出实质成果,但在真正解决开放猜想上仍然有待加强,如果说要独立攻破世界级的数学猜想,目前还有很长的路要走。
原文出处:澎湃新闻 (本文由聚合程序自动采集,版权归原作者所有)